按模态选择处理方式
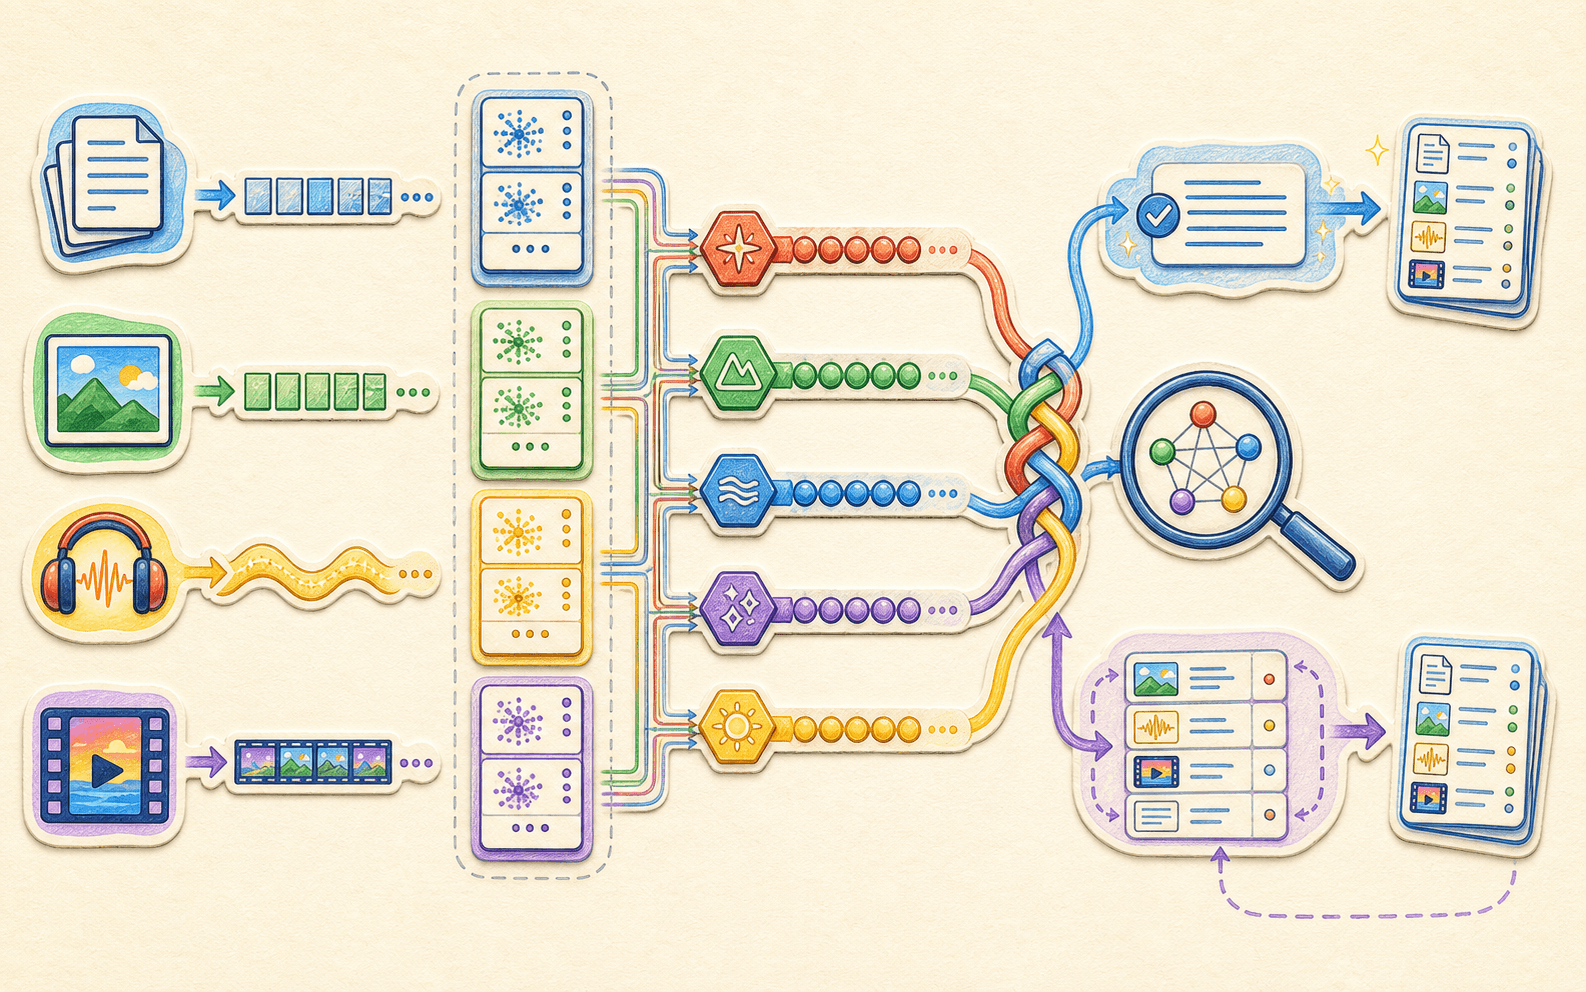
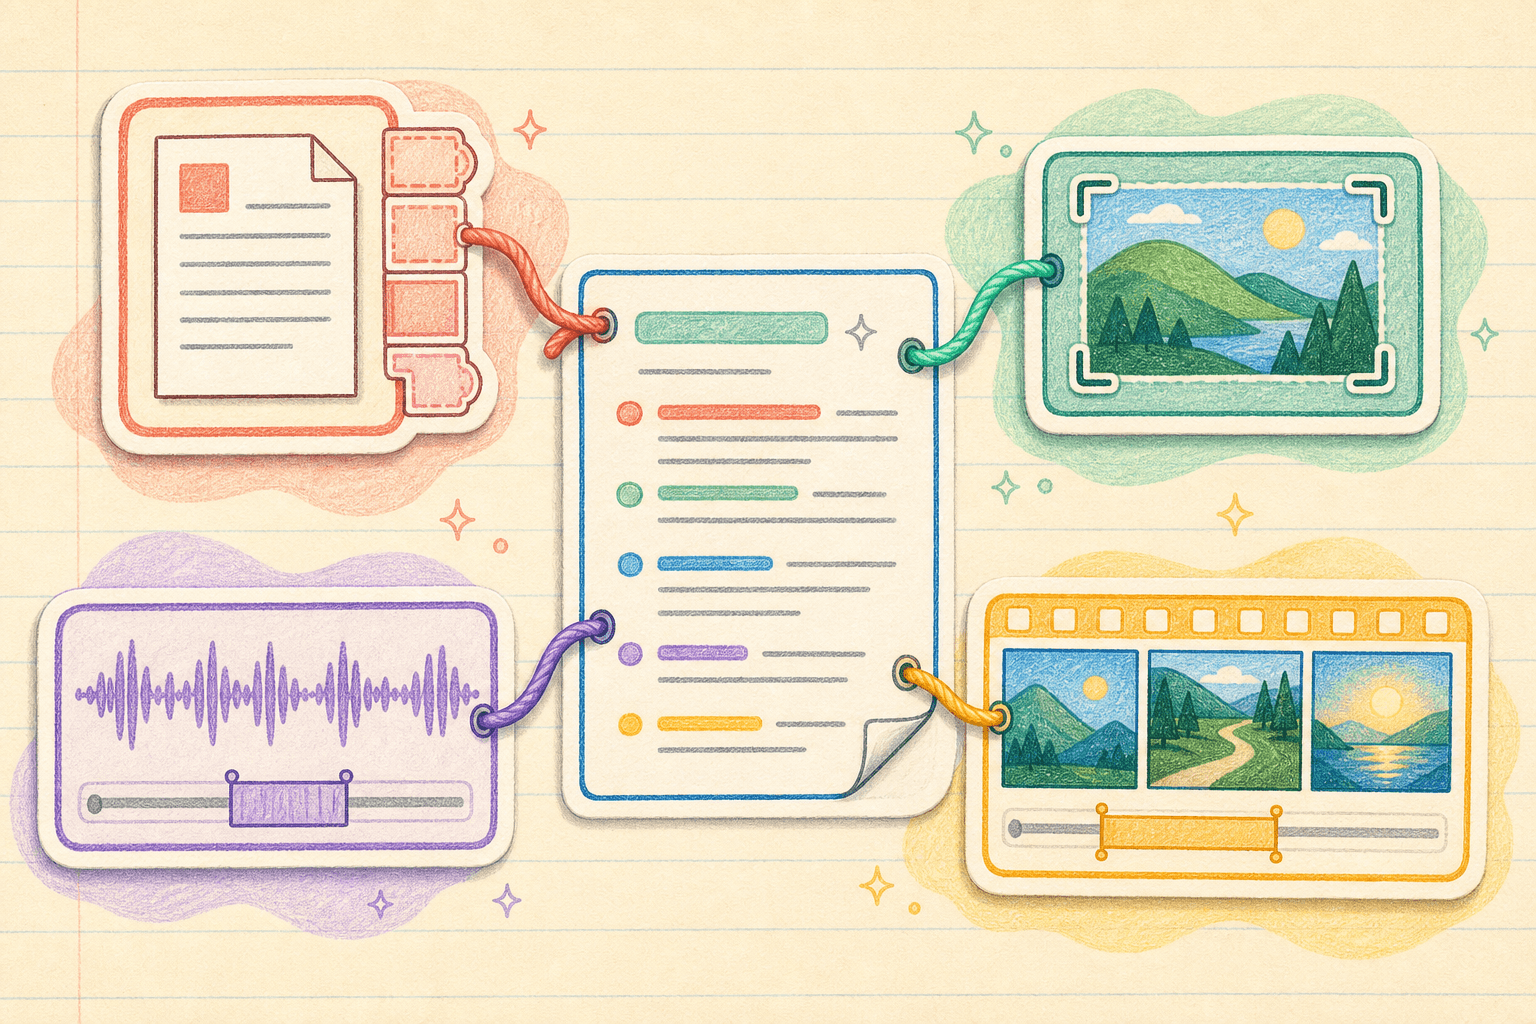
文档通过 Agentic 分块保留原文语义;图像使用 VLM 描述和 CLIP;音频使用 ASR 和 CLAP;视频围绕语义镜头建立索引,并对齐字幕、语音和关键帧画面。这样处理,是为了保留各类来源的特点,避免将它们一律转成纯文本。
统一检索多种模态,回答都能追溯来源
如何让每种模态都用适合自己的方式检索,再一起生成能核对来源的回答?
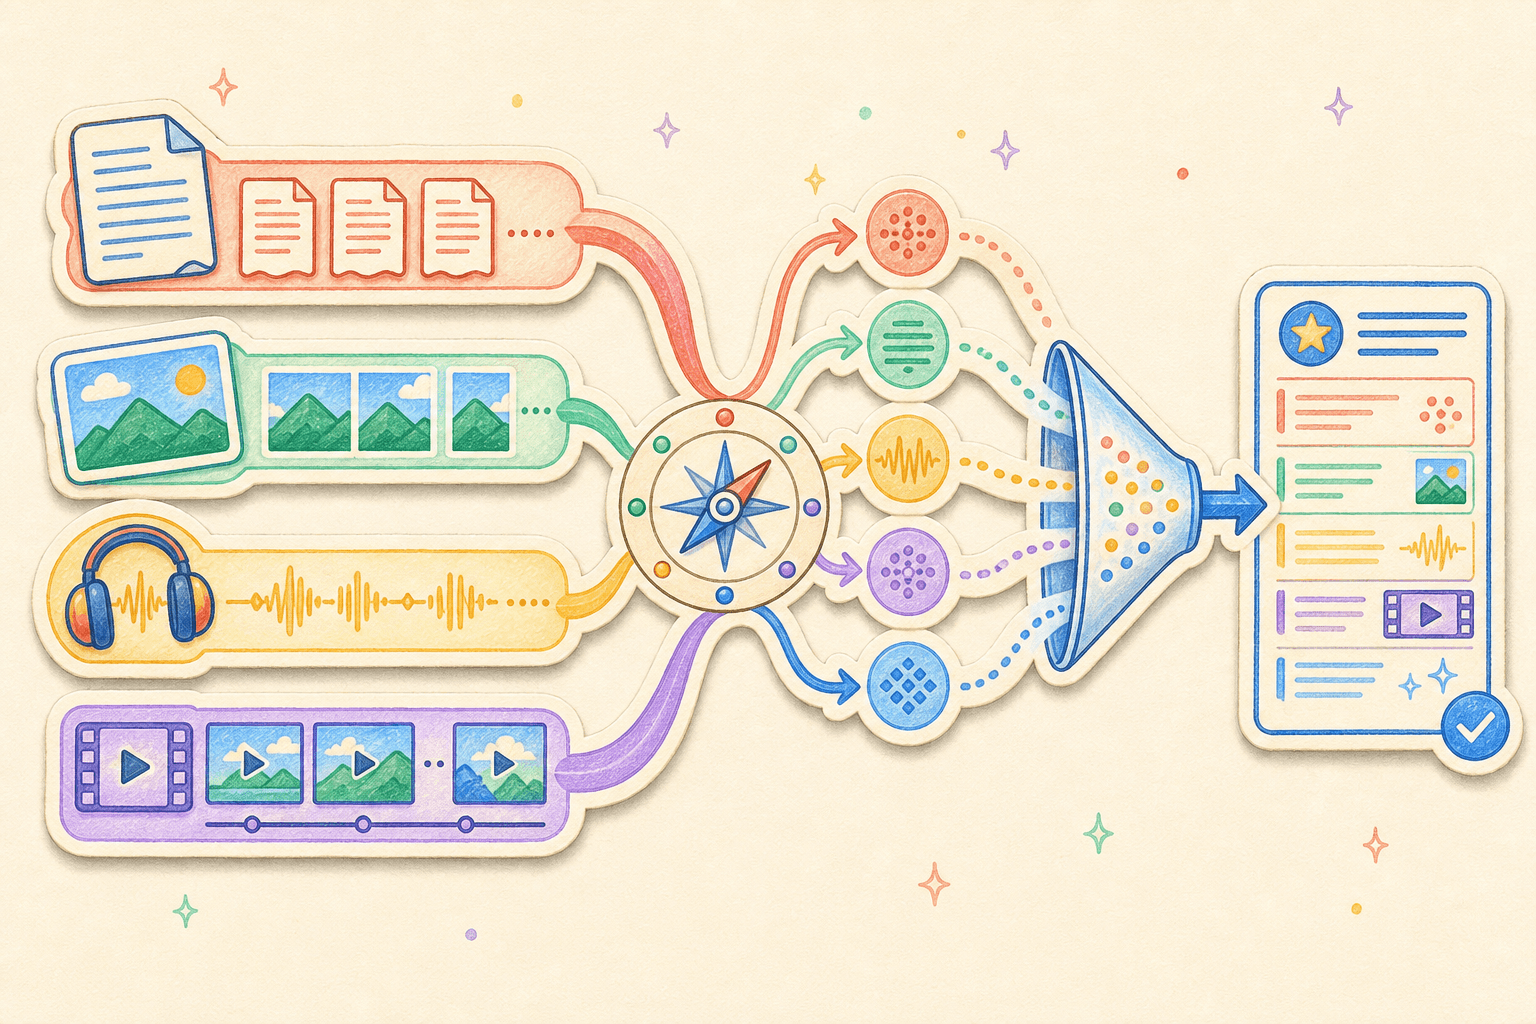
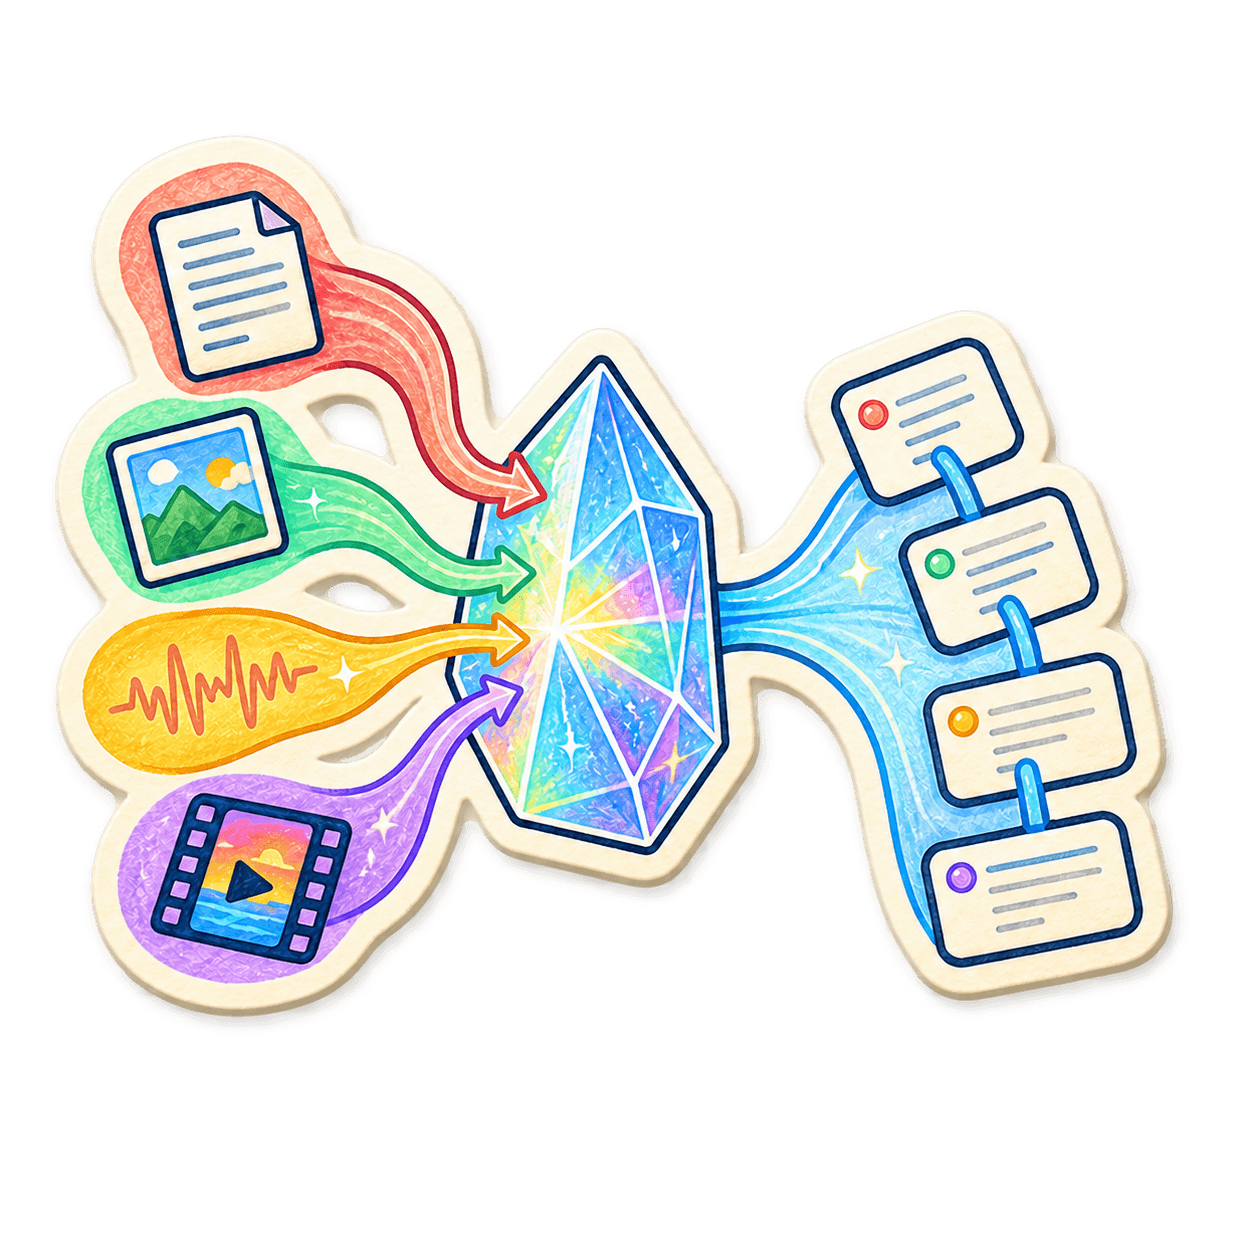
Tessmora 为文档、图像、音频和视频分别安排解析与 Embedding 流程。先通过 One-Pass 意图分析和知识库画像确定搜索范围,再进行稠密、稀疏、视觉、音频和视频检索。结果经过加权 RRF 融合与 Cross-Encoder 重排序后,可以直接生成回答,也可以在预算内通过多轮只读检索补充依据。
文档通过 Agentic 分块保留原文语义;图像使用 VLM 描述和 CLIP;音频使用 ASR 和 CLAP;视频围绕语义镜头建立索引,并对齐字幕、语音和关键帧画面。这样处理,是为了保留各类来源的特点,避免将它们一律转成纯文本。
未指定知识库时,系统根据主题画像,选择一个、多个或全部相关知识库。随后将稠密、稀疏、视觉、音频和视频检索的候选结果通过加权 RRF 融合,再用 Cross-Encoder 重排序,筛出更相关的内容。
Agent 模式会拆出相互补充的子查询,每一轮都通过同一个只读检索器并行执行。检索轮数、查询次数和证据量都有预算限制。最终流式输出时,回答正文与不同类型的引用信息分别发送。
结合界面截图和架构图,看看系统是如何实现的。